La monitorización de sistemas para empresas permite comprobar el estado de servidores, aplicaciones, redes, bases de datos y servicios digitales. Su finalidad es detectar problemas antes de que afecten gravemente a los trabajadores o clientes.
Una página web puede volverse lenta, una aplicación puede dejar de responder o un servidor puede quedarse sin espacio. Si la empresa no dispone de controles automáticos, el problema quizá no se descubra hasta que un usuario presente una reclamación.
Las herramientas de monitorización recopilan información constantemente y generan alertas cuando detectan un comportamiento inusual. De esta forma, el equipo responsable puede investigar el problema y actuar con mayor rapidez.
Sin embargo, instalar un programa no garantiza una supervisión eficaz. La empresa necesita seleccionar los sistemas importantes, definir indicadores útiles y crear procedimientos para responder a las alertas.
Tabla de contenidos
- Qué es la monitorización de sistemas
- Cómo funciona esta tecnología
- Qué elementos se pueden supervisar
- Nueve claves para monitorizar correctamente
- Tipos de monitorización empresarial
- Indicadores más importantes
- Cómo elegir una herramienta
- Seguridad y protección de datos
- Errores frecuentes
- Ejemplo práctico y preguntas frecuentes
¿Qué es la monitorización de sistemas para empresas?
La monitorización de sistemas consiste en recopilar, analizar y representar información sobre el funcionamiento de la infraestructura tecnológica.
Las herramientas pueden comprobar aspectos como:
- Disponibilidad de una página web.
- Tiempo de respuesta.
- Uso del procesador.
- Memoria disponible.
- Espacio de almacenamiento.
- Estado de las conexiones.
- Errores de una aplicación.
- Rendimiento de una base de datos.
- Utilización de servicios en la nube.
- Funcionamiento de copias de seguridad.
- Estado de dispositivos conectados.
- Experiencia de los usuarios.
El objetivo no consiste en acumular todos los datos posibles. La empresa necesita información que permita detectar problemas, investigar sus causas y comprobar si una solución ha funcionado.
La monitorización puede ser especialmente importante cuando una organización depende de una tienda digital, un CRM, un sistema de facturación o una aplicación interna.
¿Cómo funciona la monitorización empresarial?
El proceso comienza con la recopilación de métricas, registros y eventos. Estos datos pueden proceder de servidores, aplicaciones, bases de datos y dispositivos.
La información se envía a una plataforma central. Allí se organiza y se representa mediante paneles, gráficos y alertas.
El funcionamiento habitual puede dividirse en estos pasos:
- El sistema recoge información.
- La plataforma compara los valores con las condiciones establecidas.
- Detecta una desviación o un fallo.
- Genera una alerta.
- La alerta llega al responsable.
- El equipo investiga la causa.
- Se aplica una solución.
- La plataforma comprueba si el servicio se ha recuperado.
- La incidencia queda documentada.
Por ejemplo, si una página tarda demasiado en responder durante varios minutos, la herramienta puede enviar una notificación. El responsable revisa los servidores, las bases de datos y las conexiones para descubrir el origen.
¿Qué sistemas se pueden monitorizar?
Servidores
La empresa puede controlar la capacidad de procesamiento, la memoria, el almacenamiento y los servicios activos.
Un aumento constante del uso de recursos puede indicar que se necesita una mejora o que existe un proceso funcionando incorrectamente.
Redes
La monitorización de red comprueba dispositivos, conexiones y tráfico. Ayuda a detectar interrupciones, saturación y problemas de comunicación.
Aplicaciones
Las empresas pueden medir errores, tiempos de carga y disponibilidad. También pueden seguir el recorrido de una solicitud entre diferentes servicios.
Bases de datos
Se supervisan consultas lentas, conexiones, almacenamiento y otros indicadores. Una base de datos con problemas puede afectar a todas las aplicaciones que dependen de ella.
Consulta nuestra guía sobre bases de datos para empresas para conocer sus características.
Páginas y tiendas digitales
La herramienta puede comprobar si la página está disponible y si funciones importantes, como el inicio de sesión o el proceso de compra, responden correctamente.
Servicios en la nube
La computación en la nube para empresas permite contratar infraestructura adaptable. La monitorización ayuda a controlar su rendimiento, disponibilidad y costes.
Dispositivos conectados
Sensores, máquinas y otros equipos pueden enviar información sobre su estado. Esto resulta útil en proyectos de Internet de las cosas para empresas.
Copias de seguridad
No basta con programar copias automáticas. La empresa debe comprobar que se completan y realizar pruebas de restauración.
Monitorización de sistemas para empresas con 9 claves
1. Identificar los servicios críticos
La primera clave consiste en determinar qué sistemas son esenciales para el negocio. Una interrupción en el correo puede tener consecuencias diferentes a un fallo en una página secundaria.
La empresa puede clasificar los servicios según su impacto:
- Crítico.
- Alto.
- Medio.
- Bajo.
Esta clasificación ayuda a priorizar alertas e inversiones.
2. Definir indicadores útiles
Cada sistema necesita métricas relacionadas con su función. En una tienda digital, pueden ser importantes la disponibilidad, el tiempo de carga y los errores durante el pago.
Una cantidad excesiva de indicadores dificulta encontrar lo realmente importante. Es mejor comenzar con pocos valores comprensibles.
3. Establecer niveles de alerta
No todos los problemas requieren una respuesta urgente. Las alertas pueden dividirse por gravedad:
- Información.
- Aviso.
- Problema importante.
- Incidencia crítica.
Cada nivel debe indicar quién recibe la notificación y cuánto tiempo puede esperar.
4. Evitar las falsas alarmas
Si una plataforma envía avisos constantemente, los responsables pueden terminar ignorándolos. Este fenómeno se conoce como fatiga de alertas.
Para evitarlo, las condiciones deben ajustarse utilizando datos reales. Por ejemplo, un valor elevado durante cinco segundos quizá no represente un problema, mientras que mantenerlo durante quince minutos sí podría ser relevante.
5. Crear paneles comprensibles
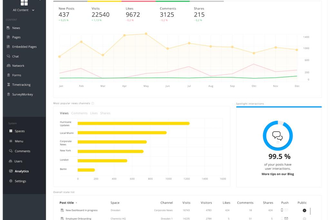
Un panel debe mostrar el estado de los sistemas sin obligar al usuario a interpretar decenas de gráficos.
Puede incluir:
- Servicios disponibles.
- Incidencias activas.
- Tiempo de respuesta.
- Capacidad utilizada.
- Copias completadas.
- Tendencias.
- Alertas recientes.
Los responsables técnicos y de negocio pueden necesitar paneles diferentes.
6. Asignar responsables
Cada alerta debe llegar a una persona o equipo capaz de investigar el problema. Si nadie sabe quién debe actuar, la notificación pierde su utilidad.
También conviene definir sustitutos para periodos de vacaciones o ausencia.
7. Documentar procedimientos
Los problemas frecuentes deberían disponer de instrucciones básicas. Por ejemplo, qué revisar cuando una página no responde o una copia de seguridad falla.
La documentación puede publicarse en una intranet para empresas para que las personas autorizadas puedan encontrarla rápidamente.
8. Revisar tendencias
La monitorización de sistemas para empresas no sirve únicamente para reaccionar. También permite observar cambios a medio plazo.
Si el espacio disponible disminuye cada semana, la empresa puede ampliarlo antes de que se agote. Esta planificación resulta más eficiente que esperar a una interrupción.
9. Mejorar después de cada incidencia
Cuando se resuelve un problema, la empresa debería analizar qué ocurrió, cómo se detectó y cuánto tardó en recuperarse.
También debe preguntarse si la alerta llegó a tiempo y qué medidas evitarían que la situación se repita.
Tipos de monitorización
Monitorización de disponibilidad
Comprueba si un servicio responde. Puede realizar solicitudes periódicas a una página, una aplicación o un servidor.
Monitorización del rendimiento
Analiza el tiempo de respuesta y el consumo de recursos. Ayuda a detectar sistemas que funcionan, pero lo hacen con lentitud.
Monitorización de red
Supervisa conexiones, dispositivos y tráfico. Permite identificar zonas saturadas o equipos que han dejado de responder.
Monitorización de aplicaciones
Estudia errores, transacciones y dependencias. Puede mostrar qué parte de una aplicación está provocando la lentitud.
Monitorización de usuarios reales
Recopila información sobre la experiencia de los visitantes, como el tiempo que tarda una página en mostrarse.
Los datos deben recogerse respetando la privacidad y utilizando únicamente la información necesaria.
Monitorización sintética
Simula acciones de un usuario. Por ejemplo, una herramienta puede abrir la página, buscar un producto y comprobar si el proceso funciona.
Monitorización de registros
Analiza los mensajes generados por sistemas y aplicaciones. Los registros pueden contener información valiosa para investigar errores.
Monitorización de seguridad
Busca comportamientos o eventos relacionados con posibles incidentes. Esta función forma parte de una estrategia más amplia de ciberseguridad para empresas.
Diferencia entre métricas, registros y trazas
Estos tres tipos de información ayudan a comprender los sistemas.
Métricas
Son valores numéricos recopilados durante un periodo. Algunos ejemplos son el uso del procesador, la cantidad de errores o el tiempo de respuesta.
Registros
Son mensajes generados cuando ocurre un evento. Pueden informar sobre un fallo, una actualización o un acceso.
Trazas
Muestran el recorrido de una solicitud entre diferentes partes de una aplicación. Resultan útiles cuando varios servicios participan en una misma operación.
Imaginemos que un cliente realiza un pedido. La traza puede mostrar el paso por la tienda, el sistema de pagos, el inventario y la plataforma logística.
Combinar estos elementos ayuda a descubrir no solamente que existe un problema, sino también dónde puede encontrarse.
Indicadores importantes para la monitorización
Disponibilidad
Indica durante cuánto tiempo ha funcionado correctamente un servicio.
Tiempo de respuesta
Mide cuánto tarda el sistema en contestar. Una aplicación puede estar disponible y resultar demasiado lenta para los usuarios.
Tasa de errores
Representa la proporción de solicitudes que terminan con un fallo.
Uso de recursos
Incluye procesador, memoria, almacenamiento y conexiones. Los valores deben interpretarse según el funcionamiento normal de cada sistema.
Tiempo de detección
Mide cuánto tarda la empresa en descubrir una incidencia.
Tiempo de recuperación
Indica cuánto tarda en restaurar el servicio después de identificar el problema.
Cumplimiento de copias
Comprueba cuántas copias programadas han finalizado correctamente.
Coste de infraestructura
En los servicios de nube, la monitorización puede detectar recursos sobredimensionados o aumentos inesperados.
Cómo elegir una herramienta de monitorización
Compatibilidad
La plataforma debe conectarse con los servidores, aplicaciones y servicios utilizados por la organización.
Facilidad de configuración
Una pequeña empresa puede necesitar una solución administrada que no exija conocimientos muy especializados.
Personalización de alertas
La herramienta debería permitir crear condiciones diferentes para cada servicio y nivel de gravedad.
Canales de notificación
Las alertas pueden enviarse mediante correo, aplicaciones de mensajería o sistemas de incidencias. Los canales deben estar disponibles incluso cuando falla parte de la infraestructura.
Integraciones
Conviene comprobar si la plataforma puede crear automáticamente tareas o incidencias en otras aplicaciones.
Las conexiones pueden desarrollarse mediante API para empresas.
Almacenamiento histórico
La empresa debe conocer durante cuánto tiempo se conservan las métricas y los registros. Un historial más largo facilita el análisis de tendencias, pero puede aumentar el coste.
Seguridad
La herramienta puede acceder a información técnica sensible. Necesita autenticación multifactor, permisos y conexiones cifradas.
Coste total
El precio puede depender del número de dispositivos, usuarios, métricas o cantidad de datos. Hay que calcular el coste actual y el que tendría después de un crecimiento.
Cómo implantar la monitorización
El primer paso es crear un inventario de sistemas y seleccionar aquellos que resultan más importantes.
Después, la empresa define qué significa que cada servicio funciona correctamente. En una página web puede ser responder en un tiempo determinado. En una copia de seguridad, completarse sin errores.
A continuación, se configuran las métricas y alertas. Antes de activar todas las notificaciones, conviene realizar una prueba con un número limitado de sistemas.
La empresa puede simular algunos fallos controlados, como detener temporalmente un servicio de prueba, para comprobar si la alerta llega al responsable.
Después del piloto, se ajustan los límites y se documentan los procedimientos. Finalmente, se incorporan otros sistemas por etapas.
La implantación no termina en ese momento. Las alertas y paneles deben revisarse a medida que cambian las aplicaciones.
Seguridad y protección de datos
Las plataformas de monitorización pueden recopilar nombres de sistemas, direcciones técnicas, registros y datos de actividad.
Para proteger esta información, la empresa debería:
- Conceder permisos mínimos.
- Utilizar cuentas individuales.
- Activar autenticación multifactor.
- Cifrar las comunicaciones.
- Limitar los datos recopilados.
- Evitar guardar contraseñas en registros.
- Definir periodos de conservación.
- Registrar los cambios administrativos.
- Eliminar usuarios antiguos.
- Proteger las conexiones entre sistemas.
El Instituto Nacional de Ciberseguridad de España proporciona recursos para ayudar a las organizaciones a mejorar su seguridad digital.
Errores frecuentes
Monitorizarlo todo desde el primer día
Recopilar miles de métricas puede aumentar los costes y dificultar la interpretación. Es preferible comenzar por los servicios críticos.
Crear alertas sin responsables
Una notificación que nadie atiende no resuelve el problema. Cada alerta debe tener un destinatario y un procedimiento.
Utilizar límites genéricos
El comportamiento normal varía entre sistemas. Los límites deberían ajustarse utilizando datos reales.
No probar las alertas
Una configuración puede parecer correcta, pero fallar cuando se necesita. Las pruebas periódicas confirman que los avisos llegan.
Ignorar los problemas intermitentes
Un fallo que desaparece por sí solo puede repetirse. Debe investigarse cuando afecta a los usuarios o indica una tendencia.
No documentar las incidencias
Sin documentación, el equipo puede repetir la misma investigación cada vez que aparece el problema.
Guardar información sensible
Los registros no deberían contener contraseñas, claves ni más datos personales de los necesarios.
No controlar el coste
Algunas plataformas cobran según el volumen de datos. Recopilar registros innecesarios puede aumentar rápidamente la factura.
Ejemplo práctico
Imaginemos una empresa con una tienda digital. Los clientes informan ocasionalmente de que la página funciona con lentitud, pero el equipo no consigue descubrir la causa.
La empresa instala una herramienta para supervisar la disponibilidad, el tiempo de respuesta, la base de datos y el uso del servidor.
Durante los primeros días, el sistema muestra que la lentitud aparece cuando determinadas consultas aumentan el consumo de recursos.
Se configura una alerta que se activa cuando el tiempo de respuesta permanece por encima del nivel normal durante varios minutos.
El equipo optimiza las consultas y crea un panel con los cuatro indicadores más importantes. También documenta los pasos que deben seguirse si el problema vuelve a aparecer.
Semanas después, una actualización provoca un nuevo aumento del tiempo de carga. La alerta llega antes de que se acumulen reclamaciones y el equipo desactiva el cambio problemático.
Después de cada incidencia, la empresa registra la causa, la solución y el tiempo de recuperación. Esta información permite mejorar tanto la aplicación como el procedimiento de respuesta.
El ejemplo demuestra que la monitorización no evita todos los fallos. Su utilidad consiste en detectarlos antes y proporcionar datos para resolverlos.
Preguntas frecuentes
¿Qué significa monitorizar un sistema?
Significa recopilar y analizar información sobre su disponibilidad, rendimiento, errores y utilización.
¿Una pequeña empresa necesita monitorización?
Sí, especialmente si depende de una página web, una tienda digital o aplicaciones esenciales. Puede comenzar con controles sencillos de disponibilidad y copias.
¿La monitorización evita todos los problemas?
No. Ayuda a detectar fallos y tendencias, pero la empresa necesita procedimientos y responsables para resolverlos.
¿Qué sistemas deberían supervisarse primero?
Los que resultan esenciales para las ventas, la atención, la facturación o las operaciones.
¿Qué es una alerta crítica?
Es una notificación relacionada con un problema que puede causar consecuencias importantes y requiere una respuesta rápida.
¿Con qué frecuencia deben revisarse los indicadores?
Depende del servicio. Las herramientas pueden comprobarlos continuamente, mientras que los responsables revisan tendencias en periodos establecidos.
¿Monitorización y ciberseguridad son lo mismo?
No. La monitorización puede detectar problemas de rendimiento y disponibilidad. Algunas de sus funciones ayudan a la seguridad, pero necesita combinarse con otras medidas.
¿Cómo se mide el éxito?
Puede medirse mediante la reducción del tiempo de detección, la disponibilidad, el número de problemas descubiertos antes que los usuarios y el tiempo de recuperación.
Conclusión
La monitorización de sistemas para empresas proporciona información sobre servidores, aplicaciones, redes, bases de datos y servicios digitales. Su principal utilidad es detectar fallos y tendencias antes de que provoquen interrupciones importantes.
Para funcionar correctamente, necesita indicadores relevantes, alertas ajustadas y responsables claramente definidos. También deben documentarse los procedimientos y revisar los resultados después de cada incidencia.
Una buena estrategia no se basa en acumular gráficos. Se basa en recibir la información adecuada, comprender su significado y actuar antes de que un problema tecnológico afecte al negocio.