El edge computing para empresas permite procesar información cerca del lugar donde se genera, en vez de enviar todos los datos a un centro remoto antes de obtener una respuesta. Esta forma de trabajar puede reducir los retrasos, disminuir el uso de las conexiones y mantener determinados procesos incluso cuando el acceso a internet presenta problemas.
Cada vez más empresas utilizan sensores, cámaras, máquinas y dispositivos conectados. Estos equipos pueden producir grandes cantidades de información de forma continua. Enviar absolutamente todos los datos a la nube puede resultar innecesario, lento o costoso.
El edge computing, también conocido como computación en el borde, traslada parte del procesamiento a dispositivos, servidores locales o equipos instalados cerca de la actividad. Después, solamente los resultados o datos necesarios se envían a los sistemas centrales.
Esta tecnología no pretende sustituir completamente a la nube. En numerosos proyectos, ambas trabajan juntas: el edge procesa las decisiones inmediatas y la nube almacena información, combina datos y realiza análisis más amplios.
En esta guía explicamos cómo funciona el edge computing, qué aplicaciones ofrece y qué debe comprobar una empresa antes de implementarlo.
Tabla de contenidos
- Qué es el edge computing
- Cómo funciona
- Diferencias entre edge computing y nube
- Ocho ventajas empresariales
- Aplicaciones principales
- Tecnologías necesarias
- Riesgos y limitaciones
- Cómo implementar un proyecto
- Ejemplo práctico
- Preguntas frecuentes
- Conclusión
Qué es el edge computing para empresas
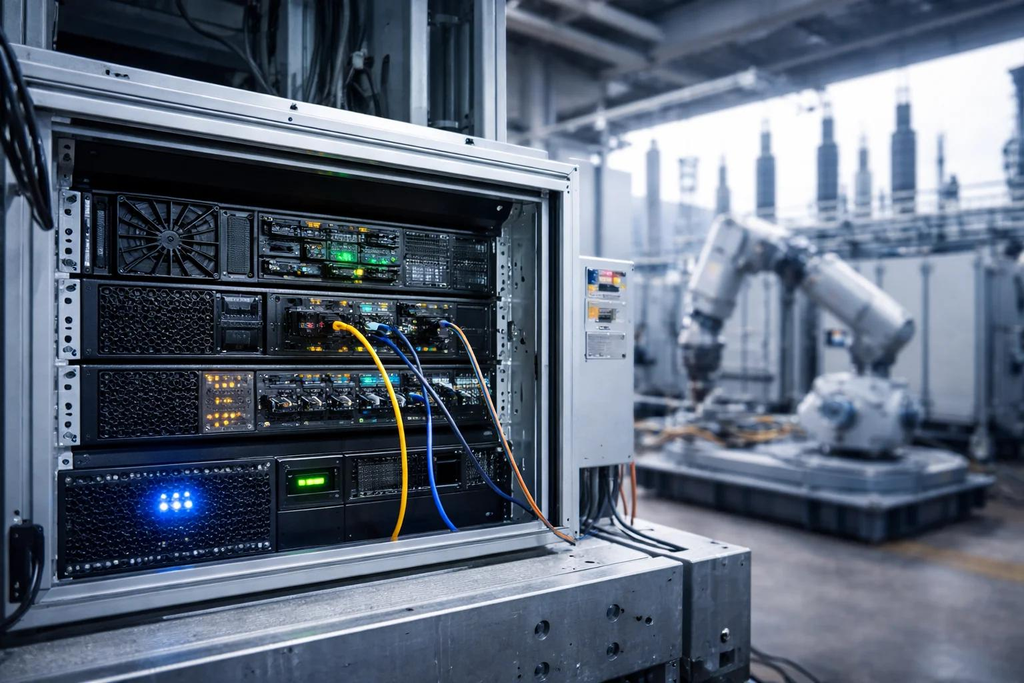
Edge computing es un modelo tecnológico que procesa datos cerca de los dispositivos y sistemas que los producen.
El “borde” no representa un único lugar. Puede encontrarse en:
- Un sensor inteligente.
- Una máquina industrial.
- Un vehículo.
- Un servidor dentro de una fábrica.
- Una tienda.
- Un almacén.
- Una antena de comunicaciones.
- Una oficina.
- Un centro de distribución.
Imaginemos una máquina que mide su temperatura cientos de veces durante una jornada. En lugar de enviar cada medición a una plataforma situada a cientos de kilómetros, un dispositivo local puede analizarla.
Si la temperatura se mantiene dentro de los niveles normales, el sistema almacena un resumen. Si detecta un valor peligroso, genera una alerta inmediatamente.
Este planteamiento reduce el volumen de información transmitida y permite actuar con mayor rapidez.
IBM explica que el edge computing acerca las aplicaciones y la capacidad de procesamiento a las fuentes de datos. Puedes ampliar esta definición en su guía sobre qué es el edge computing.
Cómo funciona la computación en el borde
El funcionamiento puede dividirse en varias fases.
Generación de los datos
Los sensores, cámaras, máquinas y aplicaciones recopilan información sobre el entorno o una operación.
Los datos pueden incluir temperatura, movimiento, velocidad, ubicación, consumo, imágenes o estado de un equipo.
Procesamiento local
Un dispositivo o servidor cercano analiza la información. Puede aplicar reglas, filtros o modelos de inteligencia artificial.
Por ejemplo, una cámara empresarial podría analizar localmente si existe una obstrucción en una zona autorizada sin enviar continuamente todo el vídeo a una plataforma externa.
Respuesta inmediata
Si se detecta una situación determinada, el sistema ejecuta una acción o envía una alerta.
La respuesta no necesita esperar a que los datos viajen hasta la nube y regresen.
Selección de la información
El dispositivo decide qué datos deben conservarse o enviarse. Puede transmitir únicamente resultados, incidencias o resúmenes.
Sincronización con sistemas centrales
La información seleccionada se envía a una plataforma central, donde puede combinarse con datos de otras ubicaciones.
Allí se elaboran informes, se actualizan modelos y se conserva el historial.
Diferencias entre edge computing y cloud computing
Computación en la nube
La computación en la nube para empresas utiliza recursos tecnológicos alojados en centros de datos externos o distribuidos.
La nube ofrece almacenamiento, capacidad de procesamiento y aplicaciones a través de una conexión.
Resulta útil para centralizar datos, ampliar recursos y permitir el acceso desde distintas ubicaciones.
Computación en el borde
El edge computing procesa parte de los datos más cerca de su origen. Puede funcionar dentro de una fábrica, una tienda o un vehículo.
Su principal ventaja aparece cuando la empresa necesita una respuesta rápida, produce demasiada información o no puede depender completamente de una conexión remota.
Modelo combinado
En muchos casos, la mejor solución combina ambos enfoques.
El sistema local toma decisiones inmediatas y la nube recibe la información necesaria para analizar tendencias generales.
No es necesario elegir exclusivamente entre edge y nube. La empresa debe decidir qué procesamiento realiza en cada lugar.
8 ventajas del edge computing para empresas
1. Menor tiempo de respuesta
Enviar datos a una plataforma remota y esperar su devolución introduce un retraso, conocido como latencia.
En tareas normales, unos segundos pueden no representar un problema. En una máquina que necesita detenerse ante una anomalía, la velocidad puede resultar mucho más importante.
Procesar localmente permite reaccionar antes.
2. Menor consumo de ancho de banda
Una cámara, una máquina o varios sensores pueden generar grandes volúmenes de datos.
El edge computing filtra y procesa la información para enviar solamente aquello que resulta necesario.
Esto reduce el tráfico y puede disminuir los costes de transmisión o almacenamiento.
3. Continuidad sin conexión permanente
Una tienda o fábrica puede continuar ejecutando determinadas funciones aunque pierda temporalmente la conexión a internet.
Cuando el servicio regresa, el sistema sincroniza los datos pendientes.
Esta capacidad debe diseñarse correctamente para evitar registros duplicados o incompatibles.
4. Mayor control sobre la información
Procesar determinados datos localmente puede evitar que toda la información salga de las instalaciones.
Esto no resuelve automáticamente las obligaciones de privacidad, pero permite diseñar arquitecturas que reduzcan la transferencia de datos.
5. Análisis en tiempo real
Los dispositivos pueden detectar eventos y reaccionar mientras ocurren.
Una máquina puede identificar una vibración anormal y un almacén puede actualizar una ubicación inmediatamente.
6. Mayor eficiencia operativa
El procesamiento local permite automatizar revisiones, generar alertas y reducir acciones manuales.
Puede integrarse con las prácticas explicadas en nuestra guía sobre automatización de procesos empresariales.
7. Escalabilidad distribuida
En lugar de enviar todos los datos a un único sistema, cada ubicación procesa parte de su información.
Esto puede facilitar la ampliación de una red de tiendas, fábricas o centros logísticos.
8. Aplicaciones avanzadas de inteligencia artificial
Algunos dispositivos pueden ejecutar modelos de IA localmente. Esto permite analizar imágenes, sonidos o datos de sensores sin transmitir cada archivo.
Los modelos deben actualizarse, supervisarse y protegerse igual que cualquier otro componente.
Aplicaciones del edge computing
Industria y fabricación
Las máquinas pueden procesar información sobre temperatura, presión, velocidad y vibraciones.
El sistema detecta comportamientos anormales y genera avisos para el equipo de mantenimiento.
Esta aplicación puede conectarse con gemelos digitales para empresas para mantener actualizada una representación virtual.
Gestión de inventario
Los lectores y sensores pueden registrar movimientos dentro de un almacén. El procesamiento local reduce el tiempo necesario para actualizar las existencias.
También permite seguir trabajando temporalmente cuando la conexión externa falla.
Comercio minorista
Una tienda puede procesar información procedente de terminales, sensores y dispositivos.
Los sistemas locales pueden actualizar precios, comprobar existencias o analizar el funcionamiento de los equipos.
Logística y transporte
Los vehículos pueden analizar información sobre rutas, estado de componentes y condiciones del transporte.
Algunas decisiones necesitan tomarse dentro del propio vehículo, sin depender de una comunicación permanente.
Edificios inteligentes
Los sistemas de climatización, iluminación y acceso pueden procesar datos localmente.
El objetivo es ajustar el funcionamiento del edificio y detectar incidencias.
Control de calidad
Una cámara industrial puede analizar los productos mientras avanzan por una línea.
El sistema puede señalar artículos que no cumplen determinados criterios y registrar la incidencia para revisarla.
Agricultura tecnológica
Los sensores pueden medir humedad, temperatura y otras condiciones. Un sistema local analiza los datos y activa determinadas acciones.
Infraestructuras
Las instalaciones energéticas, redes y equipos distribuidos pueden utilizar procesamiento local para detectar cambios y comunicar incidencias.
Relación con el Internet de las cosas
El Internet de las cosas para empresas conecta sensores y dispositivos capaces de recopilar información.
El edge computing añade capacidad para procesar parte de esos datos cerca de los dispositivos.
Imaginemos cien sensores que envían una medición cada segundo. El sistema central recibiría miles de registros en poco tiempo.
Un servidor local puede analizar las mediciones, eliminar duplicados y enviar únicamente:
- Promedios.
- Valores máximos.
- Incidencias.
- Cambios relevantes.
- Resúmenes periódicos.
Esta combinación reduce el volumen de información y facilita respuestas inmediatas.
Tecnologías necesarias
Dispositivos conectados
Los sensores y máquinas generan los datos. Deben ser compatibles, actualizables y suficientemente seguros.
Servidores o puertas de enlace
Una puerta de enlace conecta los dispositivos con otros sistemas y puede procesar información.
En proyectos mayores, la empresa puede instalar pequeños servidores cerca de la actividad.
Software de gestión
La organización necesita controlar las configuraciones, versiones y dispositivos distribuidos.
Gestionar manualmente cientos de equipos puede resultar inviable.
Conectividad
El edge puede utilizar redes cableadas, inalámbricas, móviles y otros sistemas.
Aunque algunas funciones operen sin internet, sigue siendo necesaria una conexión para sincronizar datos y aplicar actualizaciones.
Inteligencia artificial
Los modelos pueden ejecutarse en dispositivos compatibles. Esta práctica suele denominarse inteligencia artificial en el borde.
Puedes ampliar sus posibilidades en nuestra guía sobre inteligencia artificial para empresas.
Sistemas centrales
La nube o los servidores centrales almacenan información, gestionan dispositivos y combinan resultados de varias ubicaciones.
Riesgos y limitaciones
Mayor número de dispositivos
Distribuir el procesamiento implica gestionar más equipos. Cada uno debe inventariarse, actualizarse y protegerse.
Acceso físico
Los dispositivos situados en tiendas, fábricas o vehículos pueden quedar expuestos a manipulación, pérdida o robo.
Actualizaciones
La empresa necesita un sistema para distribuir correcciones y comprobar que se han instalado.
Diferencias entre ubicaciones
Si cada centro utiliza una configuración diferente, pueden aparecer errores difíciles de detectar.
Capacidad limitada
Los dispositivos de borde suelen ofrecer menos capacidad que un gran centro de datos. No todas las tareas pueden ejecutarse localmente.
Calidad de los datos
Un sensor defectuoso puede enviar información incorrecta. El procesamiento rápido no convierte automáticamente los datos en fiables.
Dependencia tecnológica
Los equipos y plataformas cerrados pueden dificultar el cambio de proveedor.
Coste inicial
Instalar servidores, sensores y sistemas de gestión requiere inversión. La empresa debe comparar el coste con la mejora prevista.
Seguridad del edge computing para empresas
Cada dispositivo conectado puede convertirse en un posible punto de entrada. Por eso, la seguridad debe incluir todo el ciclo de vida.
Entre las principales medidas se encuentran:
- Cambiar las credenciales predeterminadas.
- Crear cuentas individuales.
- Limitar los permisos.
- Cifrar las comunicaciones.
- Mantener el software actualizado.
- Separar redes.
- Desactivar servicios innecesarios.
- Registrar la actividad.
- Controlar físicamente los dispositivos.
- Preparar copias de seguridad.
- Retirar equipos antiguos de manera segura.
- Establecer un plan de respuesta.
Los sistemas deben incorporarse al inventario tecnológico de la organización. Si la empresa desconoce qué dispositivos tiene, no podrá protegerlos correctamente.
Todas estas medidas deben integrarse en el plan de ciberseguridad para empresas.
Cómo implementar edge computing paso a paso
1. Definir un problema concreto
La empresa debe comenzar con una necesidad, como reducir el tiempo necesario para detectar una avería.
No conviene instalar tecnología sin saber qué resultado debe producir.
2. Analizar los datos
Es necesario identificar qué dispositivos generan la información, cuánto volumen producen y con qué frecuencia.
También hay que comprobar la calidad de las mediciones.
3. Definir qué debe procesarse localmente
No toda la información necesita quedarse en el borde. La empresa debe dividir las tareas entre dispositivos locales y sistemas centrales.
4. Establecer los indicadores
El proyecto puede medir:
- Tiempo de respuesta.
- Datos transmitidos.
- Coste de conexión.
- Interrupciones.
- Errores detectados.
- Disponibilidad.
- Consumo energético.
5. Seleccionar los dispositivos
Los equipos deben ofrecer la capacidad necesaria, recibir actualizaciones y soportar las condiciones del entorno.
6. Diseñar la seguridad
Los permisos, las comunicaciones y la gestión de actualizaciones deben definirse antes del lanzamiento.
7. Crear un proyecto piloto
Es recomendable comenzar con una máquina, una tienda o una ubicación.
El piloto permite detectar dificultades sin afectar a toda la empresa.
8. Probar fallos
La organización debe comprobar qué ocurre si se pierde la conexión, un sensor deja de funcionar o un servidor local se apaga.
9. Documentar el sistema
La documentación debe indicar qué dispositivos existen, dónde se encuentran y quién es responsable.
10. Medir y ampliar
Si el proyecto demuestra una mejora, puede extenderse a otras ubicaciones manteniendo configuraciones comunes.
Ejemplo práctico de edge computing
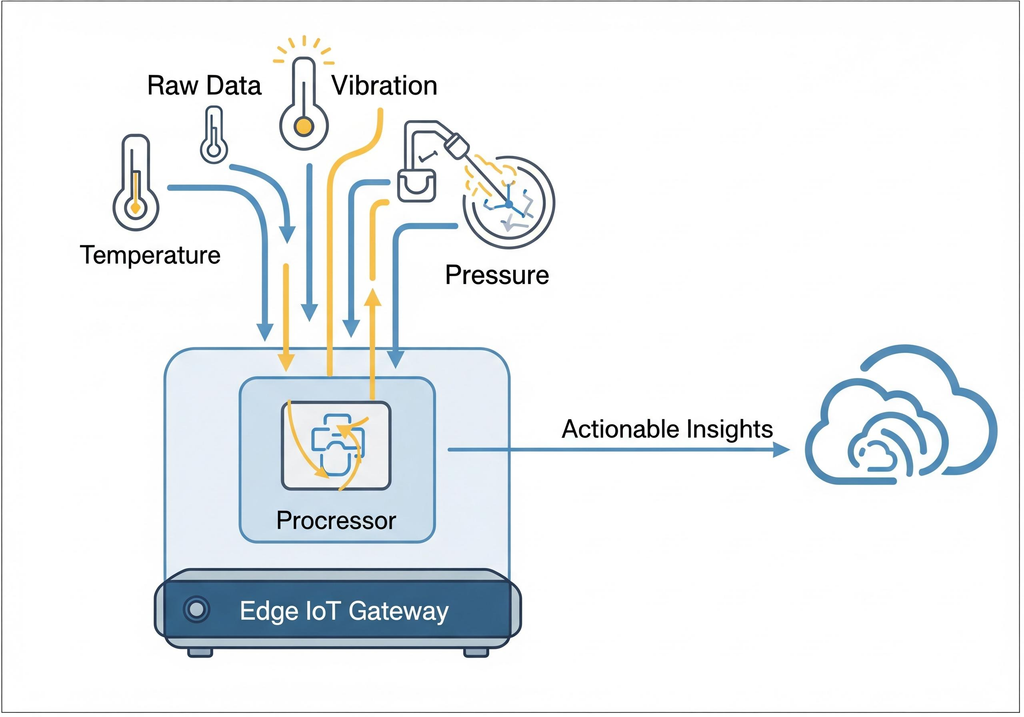
Imaginemos una empresa de alimentación que necesita controlar la temperatura de diferentes cámaras frigoríficas.
Inicialmente, los sensores envían continuamente todas sus mediciones a la nube. Si la conexión falla, el sistema deja de mostrar información actualizada.
La empresa instala una puerta de enlace local en cada centro.
El nuevo proceso funciona así:
- Los sensores miden la temperatura.
- El dispositivo local analiza los valores.
- Si todo es normal, guarda un resumen.
- Si detecta una anomalía, activa una alerta inmediata.
- Los datos relevantes se envían a la nube.
- Si la conexión falla, los registros se conservan localmente.
- Cuando el servicio regresa, el sistema sincroniza la información.
La empresa no permite que una lectura aislada tome automáticamente decisiones importantes. Configura comprobaciones y mantiene supervisión humana.
Durante el piloto mide el tiempo de respuesta, los datos transmitidos, los errores y las interrupciones.
Si los resultados son positivos, extiende el sistema a otras instalaciones.
Preguntas frecuentes sobre edge computing
¿El edge computing sustituye a la nube?
No necesariamente. Habitualmente se combinan: el edge procesa información local y la nube centraliza datos y análisis.
¿Qué significa “edge” o “borde”?
Hace referencia a ubicaciones cercanas al origen de los datos, como una máquina, tienda, vehículo o servidor local.
¿Puede funcionar sin internet?
Determinadas funciones pueden continuar temporalmente sin conexión. La capacidad depende del diseño y del almacenamiento local.
¿Solamente se utiliza en fábricas?
No. También puede aplicarse a tiendas, edificios, transporte, logística, agricultura e infraestructuras.
¿Es más seguro que la nube?
No de forma automática. Puede reducir determinadas transferencias, pero añade dispositivos que deben protegerse físicamente y mantenerse actualizados.
¿Qué diferencia existe con un servidor local?
Un servidor local puede formar parte de una arquitectura edge. El concepto incluye además dispositivos distribuidos que procesan datos cerca de su origen.
¿Necesita inteligencia artificial?
No. Puede utilizar reglas y filtros sencillos. La inteligencia artificial es una función adicional para determinados proyectos.
¿Puede utilizarlo una pequeña empresa?
Sí, especialmente si necesita respuestas locales o utiliza dispositivos conectados. Lo recomendable es comenzar con una necesidad limitada.
Conclusión
El edge computing para empresas permite procesar información cerca de las máquinas, sensores y sistemas que la generan.
Sus principales ventajas son la rapidez, la reducción del tráfico y la posibilidad de mantener determinadas funciones cuando la conexión presenta problemas.
La tecnología puede aplicarse en industria, inventario, comercio, logística y edificios inteligentes. Su utilidad aumenta cuando las operaciones necesitan responder en poco tiempo.
Sin embargo, distribuir el procesamiento también aumenta la cantidad de dispositivos que deben controlarse. La empresa necesita actualizaciones, seguridad, documentación y un plan de mantenimiento.
La mejor estrategia consiste en comenzar con un problema concreto, decidir qué información se procesará localmente y desarrollar un piloto limitado.
Cuando se combina correctamente con la nube, el Internet de las cosas y la inteligencia artificial, el edge computing puede proporcionar sistemas empresariales más rápidos, eficientes y resistentes.